 NexIP官方博客
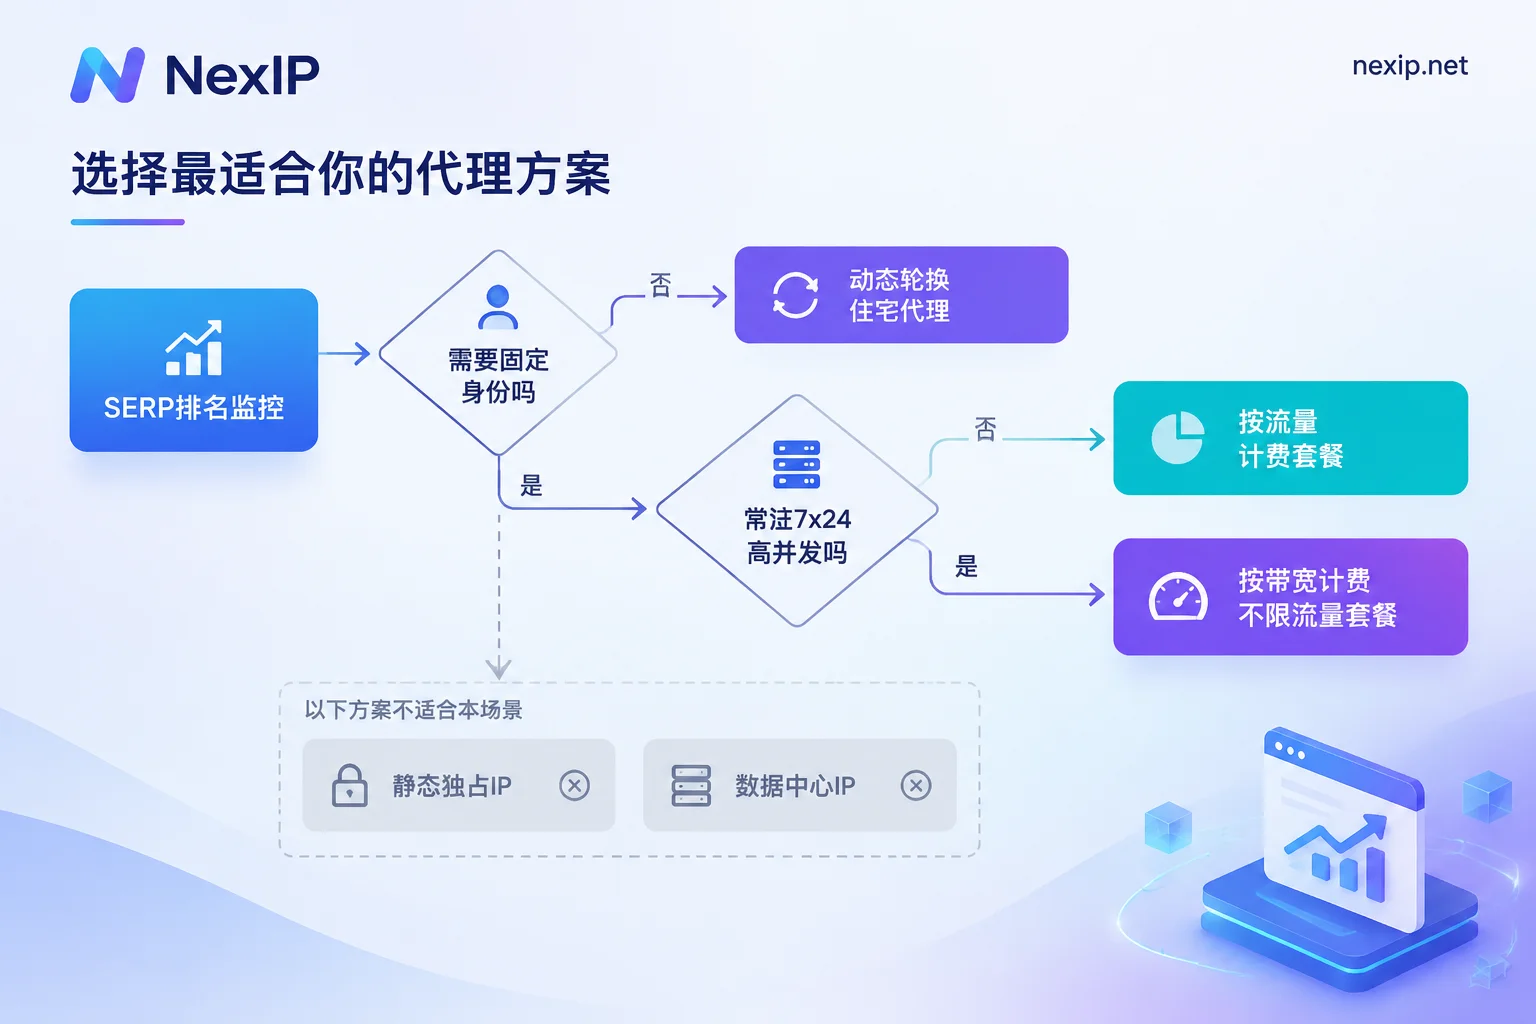
先把结论放前面:做海外搜索结果页排名监控,出口应该用动态住宅代理、按请求或按短周期轮换,而不是静态独占IP,更不是机房IP。至于买按流量计费还是按带宽计费的套餐,分界线在于你的采集是「定时轮巡」还是「常驻流水线」。
下面说清楚为什么是这个答案,哪些情况例外,以及参数具体怎么填、到手怎么验。
为什么是轮换,而不是固定出口
SERP抓取和店铺后台、社媒账号这类任务的根本区别是:它是无状态的。每一条关键词查询之间没有登录态、没有购物车、没有会话上下文,服务端不需要认出「你还是刚才那个人」。反过来,正因为不需要被认出,同一个IP短时间内打出大量结构高度相似的查询,就是最容易被风控挑出来的模式——典型表现是 429 Too Many Requests、跳验证码页,或者返回一个明显被降级的通用结果页。
把查询分散到足够大的真实家庭宽带IP池里,单个出口的请求频次自然被摊薄,这是保证成功率的底层逻辑。所以这里要的是动态住宅代理,并且默认走按请求轮换;不要为了「省事」开长粘性会话,把几百条关键词压在同一个出口上。
第二条同样重要:出口要是真实ISP归属的住宅IP,不能是数据中心IP。搜索引擎对机房ASN的信任评分低、标记速度快,拿机房IP抓SERP,要么直接被拦,要么拿到的不是当地用户真实看到的那一页——对排名监控来说,后者比被拦更糟,因为数据看起来正常,结论却是错的。
静态住宅IP在这个场景里不合适,原因不是它「不干净」,而是它的独占固定属性跟任务需求刚好相反:一个固定出口承载高频同质查询,只会更快撞上限流。静态IP的用武之地是需要稳定身份的场景,比如店铺后台绑定、社媒账号运营。如果你手上同时有这两类活,别让它们共用一套出口方案(静态那一侧的选法可以看静态短效和静态长效住宅IP该怎么选)。
一个值得留的例外
如果你除了批量抓取,还要人工定期核对少量高价值关键词——比如打开浏览器看某个城市的本地商户结果、截图存档给客户,那这条链路可以配一个固定出口,好处是每次看到的地域上下文完全一致,不受轮换带来的定位漂移干扰。但这属于小流量的人工核验通道,和主采集流水线分开走,别混用。
买流量套餐还是带宽套餐
两种计费方式对应两种采集节奏,先看你属于哪一种。
按流量计费的动态套餐适合:关键词量在中小规模、按天或按周定时轮巡、任务有明显的高峰和空窗期。SERP抓取的数据量本身很轻——只要在爬虫里阻断图片、CSS、字体和视频,只取HTML或直接解析结构化接口,单次查询通常只有几十KB到几百KB。这种用量按流量买最划算,空窗期不产生费用。
按带宽计费、不限流量的动态套餐适合:关键词库规模大、7×24小时不间断跑、多地区多语言并行的企业级流水线。到了这个量级,按流量算成本会随关键词数线性上涨且不好预估,而按带宽买的是一个并发上限,成本是确定的,超出部分只体现为速度,不体现为账单。
判断门槛可以先用一个粗估公式跑一遍:
月流量 ≈ 关键词数 × 每日频次 × 每次抓取页数 × 单页字节 × 重试系数 × 30重试系数按实测的验证码率和失败率来定,不要按1算。跑完估算别直接下单大包,先用小额度做一轮真实采样,因为不同搜索引擎、不同地区、带不带地图包的结果页,体积差异可以有好几倍。估算方法和采样口径可以参考动态住宅流量套餐的用量怎么估。
一条实用的切换线:当你发现每月流量费已经接近同等并发能力的带宽套餐价格,或者为了控成本开始主动砍监控频次、砍关键词,就该换到带宽口径了。
地域定位:这是SERP监控最容易翻车的地方
排名监控的结果和IP物理位置强相关。同一个关键词,在不同国家、甚至同一国家的不同城市,自然排名、本地商户列表、地图包的内容都可能不同。所以代理必须支持指定国家,最好能指定州省和城市。
但只选对出口位置还不够,爬虫端的参数必须和出口对齐,否则会出现互相打架的结果:
- 搜索引擎的地域与语言参数(Google 的
gl、hl,以及涉及精确位置时的uule)要和代理出口国家一致; - HTTP 请求头的
Accept-Language要和目标地区的常用语言一致,别拿一个美国出口配中文语言头; - 浏览器时区、区域设置、User-Agent 也要跟着一起改,不要出现「德国IP + 美东时区 + 日语界面」这种组合;
- 如果监控的是本地服务类关键词,城市级定位就不是加分项而是必需项。
城市和ASN这类定向参数在下单时怎么填、到手怎么核对,可以看城市定向和ASN定向:下单怎么填参数,到手怎么验;判断拿到的IP定位是否真的落在目标城市,方法在如何判断海外住宅IP的地理位置精准度。
协议、认证和接入方式怎么配
协议:HTTP/HTTPS 够用;如果你的采集器要复用连接、或者跑在非HTTP的组件里,选 SOCKS5 更省事。
认证:SERP采集通常是多机、多容器、并发拉起,出口IP可能不固定,这时候账密认证比白名单更省心——换一台机器不用重新报白。只有当你的采集节点跑在固定公网IP的服务器上、且不会频繁增减,白名单才有优势(少一次握手、配置更干净)。两者的取舍详见代理IP账密认证和白名单认证怎么选。
接入方式按你的架构来挑:
- 账密直连:最常见,在 Requests、HTTPX、AIOHTTP、Playwright 里配一行 proxy 就能跑,具体写法见住宅代理怎么接进 Python 采集脚本;
- API 提取:适合自己管理IP列表、想控制轮换节奏或做失败IP剔除的场景;
- 端口转发:适合不方便改代码、靠本地端口映射把流量导出去的旧系统。API提取和端口转发的差别见这篇对比;
- 进程代理:只想让某一个采集程序走代理、其他流量走本地时用,做法在进程代理怎么只让一个软件走代理。
另外提醒一句:SERP场景不需要配粘性会话。如果你的工具默认开了会话保持,记得关掉或缩到最短,否则轮换等于没开。
只换IP不够:客户端指纹也要对上
这是很多团队买了住宅代理还是被拦的真实原因。现在的搜索引擎风控同时看三层:IP 信誉、TLS 握手特征(JA3/JA4)、浏览器行为指纹。用原生 curl 或 Python requests 直连,IP 再干净,TLS 指纹也会暴露成「这不是浏览器」。
对应的做法:
- 轻量路线用
curl-impersonate之类能模拟真实浏览器TLS指纹的客户端; - 需要渲染或处理交互的,用 Playwright / Puppeteer 跑无头浏览器,并对齐 UA、时区、语言、屏幕参数;
- 建立验证码率与失败率的监控指标,不要只统计「抓到了多少条」,还要统计「多少次被拦」——这个数字是你调并发和退避间隔的唯一依据。
补充一点前提:各大搜索引擎从不公开单IP的速率阈值,网上流传的「每IP每分钟N次」都是别人的实测值,不能照搬。并发和重试退避必须在你自己的关键词组合、地区、时段下实测出来。
浏览器环境这一层属于指纹隔离的范畴,NexIP 只负责网络出口,浏览器指纹侧可以交给 NexBrowser 处理,两者分工不要混。
到手后的五步验证
下单接上之后,先跑这套再上量:
- 出口核对:随机取若干次请求,查出口IP的国家、州省、城市和ASN类型,确认是住宅ISP归属而不是托管商,且落在目标地区;
- 轮换核对:连续发若干次请求,记录出口IP,确认按预期轮换、没有被会话粘住;
- 本地化核对:用同一个关键词分别从两个不同国家出口抓一遍,结果差异应当明显——如果两边结果几乎一致,说明地域没真正生效,回去查
gl/hl和位置参数; - 成功率采样:跑一批真实关键词,统计 200 正常返回、429、验证码页各占多少,把这个基线记下来,后续任何波动都拿它对比;
- 流量采样:记录这一批抓取实际消耗的字节数,回代到前面的估算公式里,再决定买流量包还是带宽包。
第5步顺序不能反——先小额采样,再决定套餐规格,能省掉一次买错档位的成本。
去哪一档下单
把上面的判断收敛一下:
- 关键词规模中小、按天或按周定时轮巡、有明显空窗期 → 选动态住宅流量套餐,按请求轮换,不开粘性;
- 关键词库大、常驻高并发、多地区并行、希望成本可预测 → 选动态住宅带宽套餐,不限流量,按并发规划规格;
- 需要确认目标国家或城市是否覆盖,先去按国家看覆盖对一遍,再回来定规格。
最后强调一句适用边界:以上是针对你自有业务的合规排名监控与数据采集给出的出口选型。抓取节奏、频次和目标站点的服务条款要自己把关,代理解决的是出口归属和分散度的问题,不能替代对采集行为本身的合规判断。


评论(0)