 NexIP官方博客
在2026年的公开数据采集工程中,许多爬虫开发者都遇到过一种让人哭笑不得的困境:发现传统 requests 库频繁返回 403 后,连夜把代码重构成了支持浏览器指纹伪装的 curl_cffi 或魔改版无头浏览器(如 Patchright、Camoufox);或者咬牙采购了一批住宅代理替换掉廉价机房 IP。结果脚本刚跑起来不到半小时,要么继续卡在 Cloudflare Turnstile、DataDome 的质询页,要么看似满屏 HTTP 200 OK,入库清洗时才发现抓回来的全是价格错乱、库存虚标的“掺水假数据”。
到了今天,靠“单点突破”对抗反爬的时代已经彻底翻篇。现代 WAF(Web 应用防火墙)与风控引擎看的是整条请求链路的特征自洽性。如果只改客户端指纹却不讲究网络出口的匹配逻辑,或者只堆砌代理池却忽略了传输层协议的暴露,再好的代码和再贵的 IP 都会沦为消耗品。
本文将从 2026 年反爬对抗的一线痛点出发,拆解网络出口是如何与 TLS/JA4 指纹、会话状态深度绑定的,并探讨如何合理配置爬虫代理IP,搭建一套既抗封禁又具性价比的采集架构。
一、2026反爬新常态:从“显式拦截”到“静默投毒”与全链路校验
过去排查爬虫代理 IP 是否失效非常简单:看状态码是不是 403/429,或者看响应体里有没有验证码关键字。但在 2026 年,主流电商、本地生活与内容平台的防御策略发生了两项核心转向:
1. 隐性放水与“数据投毒”常态化
直接封禁 IP 只会逼迫采集方加快轮换频率。如今风控系统在识别出可疑流量后,往往不会立即断开连接,而是采取降级响应(Silent Degradation):
- 对可疑 IP 返回缓存的历史旧数据或随机微调过的虚假价格;
- 故意丢弃部分 JSON 字段(如隐藏真实评论列表或促销优惠券);
- 拉长响应延迟,拖慢爬虫整体并发吞吐。
这种“静默投毒”对数据团队的杀伤力极大——状态码全是 200,监控告警毫无反应,直到业务端发现比价失真或 AI 训练语料被污染时,往往已经白白烧掉了大量算力与代理预算。(如果你在 AI 实时检索中也遇到过类似问题,可以参考《AI Agent与RAG实时检索总拿到假页面?动态住宅IP在AI数据管道中的配置逻辑》。)
2. 三层联动的“木桶效应”
为什么风控能精准揪出伪装过的爬虫?因为现代边缘网关(以全面普及 JA4 指纹检测的 Cloudflare 和拥有数十种行为模型的 DataDome 为代表)在请求到达的几毫秒内,会同时完成三层交叉核验:
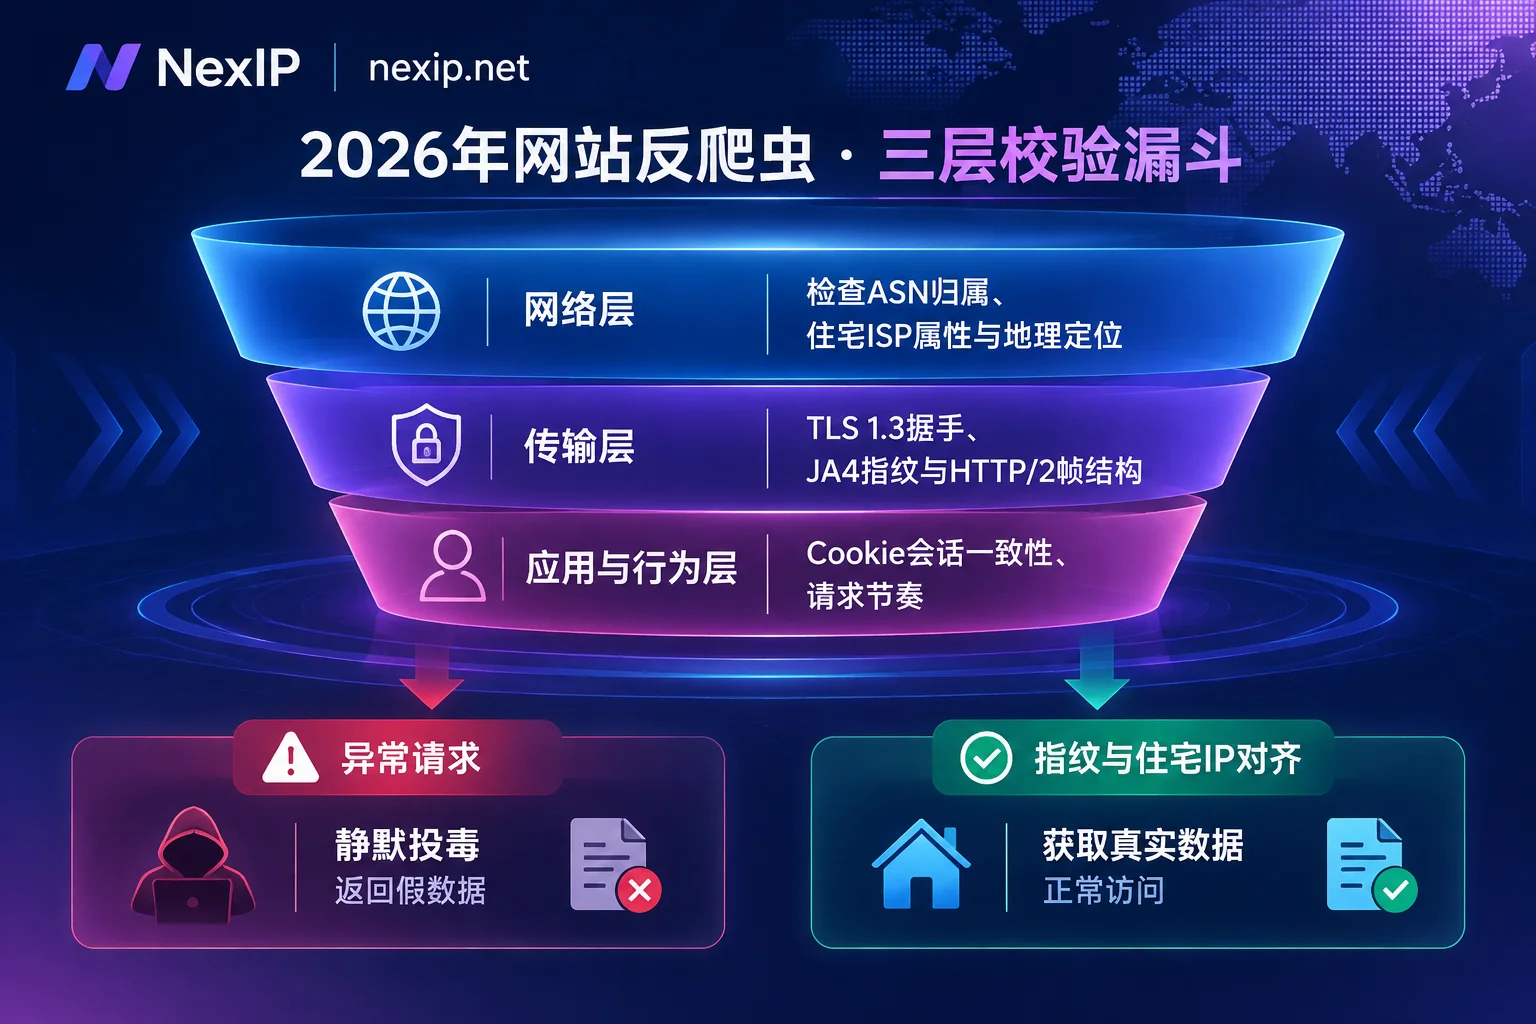
- 网络层(IP 信誉与 ASN 画像):检查出口 IP 属于机房网段还是真实家庭宽带 ISP,近期是否有高频异常请求记录,以及 IP 归属地与目标站点的业务区域是否吻合。
- 传输层(TLS 握手与 HTTP/2、HTTP/3 帧特征):传统的 JA3 指纹因浏览器扩展顺序随机化已逐渐失效,2026 年防守方普遍采用对扩展排序后再哈希的 JA4 指纹,并结合 HTTP/2 的
SETTINGS帧参数、窗口大小来识别底层网络库。 - 应用与行为层(环境一致性与访问轨迹):核对请求头、时区语言、Cookie 令牌以及请求间隔节奏是否符合人类浏览逻辑。
这三层构成了典型的木桶效应。爬虫代理IP是第一道准入门槛:如果使用的是早已被标记的机房共享段,请求在建立连接阶段就会被贴上高危标签,后面花再大力气做 Canvas 指纹混淆或鼠标轨迹模拟也是徒劳;反之,即便用上了高纯净度的真实住宅 IP,如果在代理接入方式和会话调度上犯了低级错误,干净的 IP 也会在几分钟内被迅速拉黑。
二、为什么换了住宅代理还会暴露?三个常见的“指纹×IP”错配坑
在实际工程排查中,许多团队买了优质住宅 IP 依然被封,问题通常出在客户端与代理出口的协同细节上:
坑点 1:质询令牌(Clearance Cookie)与出口 IP 突然解绑
在面对带有前置五秒盾或无感验证的站点时,客户端需要先通过一次环境校验,拿到类似 cf_clearance 或 datadome 的通行 Cookie,随后才能请求核心业务接口。
不少开发者在代码里配置了“每请求轮换(Per-Request Rotation)”的动态代理:第 1 个请求用美国的 IP_A 拿到了通行令牌,紧接着第 2 个请求带着这个令牌去抓商品详情,但底层出口已经变成了德国的 IP_B(甚至同城不同 ASN 的另一个 IP)。在服务端风控看来,通行令牌绑定的 IP 与 TLS 会话特征瞬间漂移,属于典型的凭证盗用或分布式爬虫行为,不仅当前请求会被拦截,连带新换上去的 IP_B 也会立刻被连坐降权。
坑点 2:代理连接协议不当,破坏了底层 TLS 与 ALPN 协商
当你使用 curl_cffi 模拟 Chrome 浏览器的 TLS 握手时,客户端期望直接与目标服务器完成端到端的 TLS 1.3 握手及 HTTP/2、HTTP/3 (QUIC) 协议协商。如果在接入爬虫代理 IP 时配置不当(例如在部分老旧的中间层转发架构下被强制降级了协议,或者泄露了 Via、X-Forwarded-For 等代理特征头),就会导致客户端声明的 User-Agent 与实际到达服务端的传输层指纹产生撕裂。
因此,在对传输层指纹极其敏感的高风控采集场景中,建议优先采用支持原生隧道透传的 HTTPS CONNECT 或直接走底层 SOCKS5 协议接入,确保本地构造的加密套件顺序、扩展列表和 ALPN 协商参数原封不动地抵达目标站点。(关于 SOCKS5 协议在复杂网络架构中的优势,可进一步阅读《SOCKS5代理配置:从协议基础到高性能跨境业务架构》。)
坑点 3:IP 地理/运营商属性与客户端环境“跨服聊天”
全链路校验非常看重“逻辑自洽”。比如你的爬虫脚本在请求头里写死了 Accept-Language: ja-JP,或者无头浏览器注入了东京时区,意图抓取日本本土电商平台的区域限定价格,但接入的代理池却随机分配了一个英国或美国的出口 IP。这种跨国界的特征冲突,哪怕单看 IP 纯净度再高、TLS 指纹再像真机,也会立刻触发风控的异常评分,直接返回默认站点的兜底假数据。(关于如何深入检验 IP 纯净度与 ASN 归属,可参考《代理IP纯净度怎么定义?除了看ASN和归属地,这才是风控绕不开的真相》。)
三、爬虫代理IP协同配置实战:让出口调度匹配业务特征
要跳出“频繁被封—盲目换 IP—账单爆炸”的死循环,核心在于根据目标站点的风控机制,精细化调度代理 IP 的会话生命周期、地域定向与计费模型。
作为专注于提供纯净网络出口基础设施的服务商,NexIP 提供了完整的动静态住宅代理产品线,全面支持 HTTP/HTTPS/SOCKS5 协议,并提供 API 提取、账密认证、端口转发及进程代理四种接入方式,方便开发团队无缝嵌入现有的 Python、Go 或 Node.js 采集框架中。
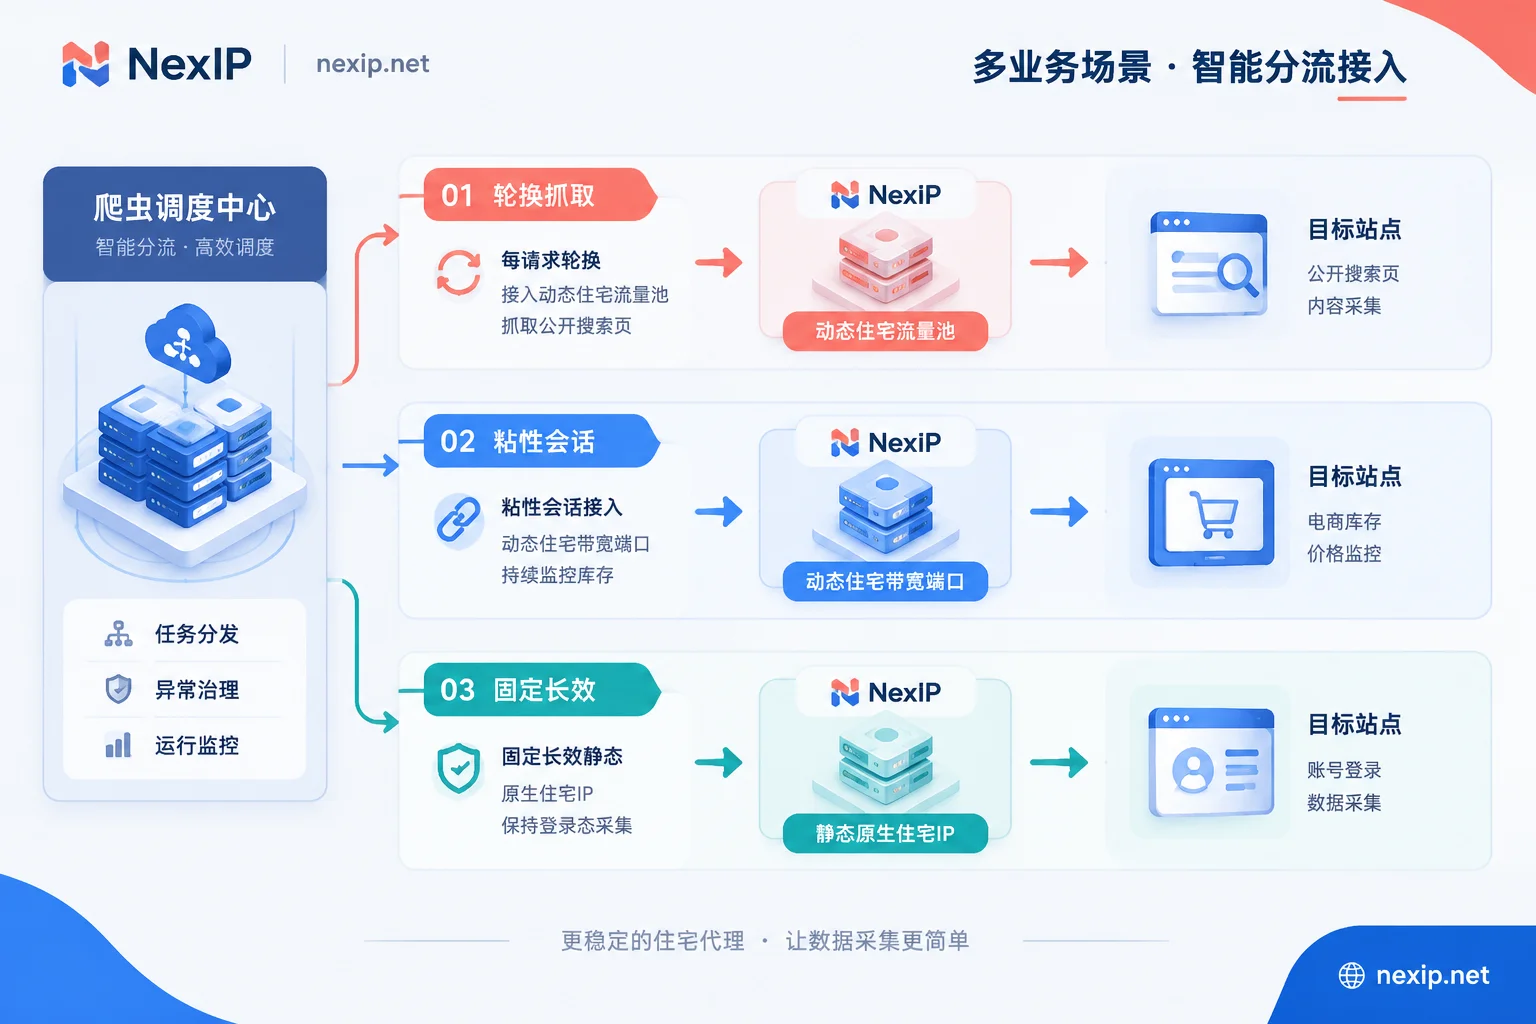
针对不同的采集任务,我们建议按以下策略配置网络出口:
1. 公开页面高并发遍历 vs 多步交互抓取:用好轮换与粘性会话
并不是所有爬虫都适合“一请求一换 IP”。在接入动态住宅代理时,必须根据业务单元来设定会话模式(具体切换逻辑可参考《动态IP多久换一次比较合适:按工作单元和风控信号换,而不是按秒数换》):
- 无状态单页抓取(如搜索引擎 SERP 抓取、独立商品快照):可使用每请求轮换模式,每次连接自动分配全新的真实住宅出口,将高频请求均匀稀释到庞大的 IP 池中,规避单 IP 速率限制(Rate Limit)。
- 有状态连续采集(如过盾后翻页、输入邮编查库存、多跳 API 调用):务必开启粘性会话(Sticky Session)。在同一个工作单元(如“加载首页拿 Cookie → 搜索关键词 → 翻页抓取前 5 页详情”)周期内,固定使用同一个住宅 IP、同一套 TLS 指纹与请求头;待该任务单元彻底完成后,再销毁会话并轮换下一个 IP 与指纹组合。
2. 精准对齐地域、城市与 ASN 运营商
采集对地域敏感的业务(如本地化广告验证、各国搜索引擎排名监控、区域房价与外卖酒店比价)时,不能只做粗放的国家级别定向。通过 NexIP 全球节点覆盖,工程团队可以按国家、城市、甚至具体的 ASN 和当地宽带运营商进行精细化定向(视实时库存而定)。
在发起请求前,通过代理账密参数指定目标城市的住宅出口,同时在爬虫中间件里同步加载对应城市的语言偏好、地理坐标与时区配置,实现从底层网络路由到上层应用特征的严丝合缝。
3. 按任务吞吐形态选型:流量套餐、带宽套餐与静态住宅 IP
在解决了通过率之后,工程负责人最关心的往往是采集成本。如果选错了代理计费模式,遇到页面体积膨胀或重试率波动时,预算很容易失控(详见《为什么你的代理账单总超支?拆解“失败乘数”陷阱与不限流量代理IP的成本重构》)。
在 NexIP 的产品矩阵中,你可以根据数据管道的运行特征做分层组合(架构设计细节可参考《爬虫代理IP接入架构设计:按任务分级、Cookie绑定与双池调度指南》):
| 采集任务形态 | 推荐 NexIP 产品类型 | 核心特性与调度方式 | 典型适配场景 |
|---|---|---|---|
| 高离散度、轻量请求、需极高匿名度 | 动态住宅代理·流量套餐 | 按流量(GB)计费;支持每请求轮换或粘性会话;调用精简接口或屏蔽重型静态资源时单次成本极低 | 电商比价采集、广告验证、SEO/SERP 监控、旅游聚合及 AI 语料采集与 RAG 检索 |
| 7×24小时持续运行、高吞吐大页面抓取 | 动态住宅代理·带宽套餐 | 按端口带宽计费,不限流量(遵循公平使用原则);支持自动轮换或粘性会话,成本固定可预测 | 全天候舆情监测、实时库存追踪、高频 API 轮询、需完整渲染 DOM 的无头浏览器集群 |
| 短周期独占验证、临时测试联调 | 静态住宅代理·短效 IP | 小时或天级租期,按 IP 计费,不限流量;独占固定的静态住宅(ISP)出口 | 临时账号验证、支付流程验证、爬虫脚本上线前的定点测试联调 |
| 需长期维持高权重登录态的采集与运营 | 静态住宅代理·长效 IP | 月或年级租期,不限流量;独占固定出口,含家宽原生、家宽广播、数据中心子类,支持原生双 ISP,失效免费更换 | 需挂载老账号 Cookie 抓取闭源平台数据、长期保持 AI 账号登录态、跨境店铺管理与 TK 运营 |
注:对于需要长期固定身份的业务,如果目标平台对网络属性审查极为苛刻,建议提前了解 家宽原生 IP 与家宽广播网段的区别,优先选用本地 ISP 直属的家庭宽带原生 IP,最大限度降低账号风控异常概率。
四、上线前的工程自检清单:4步排查网络与特征泄漏
在将大规模爬虫集群推向生产环境前,建议数据工程师按以下清单跑一遍冒烟测试,避免带着明显破绽去消耗代理资源:
- 校验 TLS/JA4 与 HTTP/2 握手一致性:通过代理访问公开的指纹回显测试站点,确认请求经过 SOCKS5 或 HTTPS 代理隧道后,服务端看到的 JA4 哈希值、ALPN 协议版本(是否正常协商为
h2)与本地声明的 User-Agent 版本完全吻合。 - 核查会话粘性周期与重连逻辑:模拟连续 10 次带状态的 API 请求,检查粘性会话(Session ID)是否稳定保持在同一出口 IP;同时编写异常捕获逻辑——一旦某个粘性 IP 触发 403 或质询,立即主动更换 Session ID 切换新 IP,并清空旧的 Cookie 容器,切勿原地死磕重试。
- 建立“静默投毒”的数据校验哨兵:不要只用
status_code == 200判断采集成功。在解析层加入黄金样本比对或关键字段非空断言(例如核验商品价格区间是否合理、特定 DOM 节点是否存在)。当发现某批返回数据出现结构性降级时,及时触发告警并调整对应任务的代理池区域或并发节奏。 - 利用子账户与 API 做好多团队隔离:如果团队内部同时跑着“公开页面高频扫描”和“高价值登录态抓取”两类任务,切忌混用同一批固定出口。你可以通过 NexIP 用户后台(user.nexip.net) 创建独立的子账户,结合官网面板或管理 API 为不同优先级的爬虫分配专属的流量池、带宽端口或静态长效 IP,实现权限、成本与风控边界的清晰隔离。
结语
2026 年的数据采集攻防,本质上是一场关于细节真实度与工程成本效率的较量。当你在代码层利用 curl_cffi 或新一代反检测浏览器补齐了客户端指纹短板后,更需要一个纯净、稳定、调度灵活的住宅代理底座来承接这些请求。
现在即可前往 NexIP 用户后台 注册并查阅接入文档,根据你的采集场景灵活组合动态流量、不限流量的动态带宽或静态住宅 IP,让每一行爬虫代码都能稳定、高效地拿到真实数据。