 NexIP官方博客
在把大模型接入生产环境时,很多开发团队会遇到一个比 403 Forbidden 更棘手的问题:HTTP 状态码全部是 200 OK,没有弹窗验证码,也没有连接重置,但塞进向量数据库或喂给模型的文本却驴唇不对马嘴。
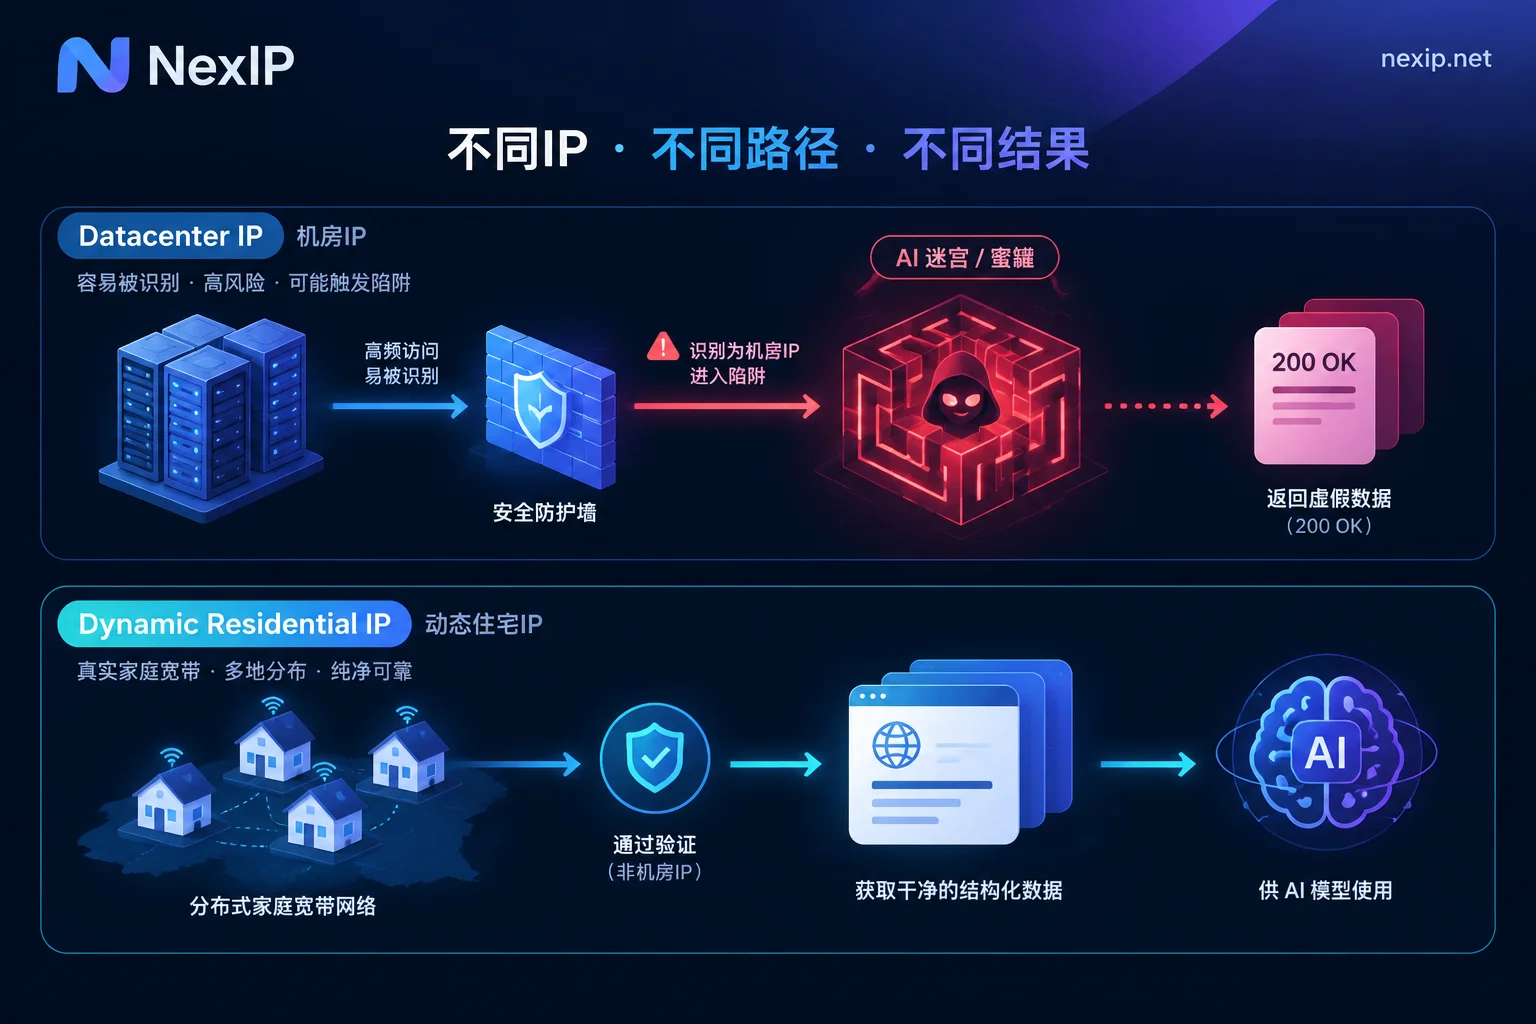
随着自动化流量占比持续攀升(据 Imperva《2026 恶意机器人报告》统计,自动化流量已占全网流量的 53% 以上;HUMAN Security 的基准报告也显示网页抓取请求在一年内激增了 47%),主流安全厂商的防御策略已经变了。以 Cloudflare 普及的 AI Labyrinth(AI 迷宫)为例,当风控识别出非受邀的自动化抓取或低信誉出口时,不再直接拦截报错,而是利用生成式 AI 动态注入隐藏链接和逼真的虚假页面,把爬虫引向无尽的死胡同。
对传统爬虫来说,这只是浪费了带宽和算力;但对依赖外部实时信息的 RAG(检索增强生成)系统和自主执行任务的 AI Agent 来说,抓回来的假数据会直接污染知识库,诱发严重的模型幻觉。
要让 AI 数据管道拿到干净、真实的网页内容,除了在解析层做内容校验,更关键的一步是在请求发出前,把网络出口换成高信誉的动态住宅IP。
一、为什么传统机房出口撑不起 AI Agent 集群?
三年前跑个脚本抓几百页静态网页,找批便宜的数据中心(机房)IP 加上随机延迟就能凑合用。但在 AI 工作流里,请求特征发生了根本变化:
- 高并发扇出(Fan-out):当用户在前端向 Deep Research 类应用或 RAG 助手提一个复杂问题,后台会在几秒内拆解出数十个子查询,同时向搜索引擎、新闻源、电商或垂直社区发起并发请求。
- 真实浏览器交互:现在的 AI Agent 框架(如基于 Playwright、Browser Use 构建的智能体)通常会驱动无头浏览器去执行点击、翻页、表单填写等多步操作。
机房 IP 的 ASN(自治系统号)归属非常集中且公开透明,目标站点的 WAF 甚至不需要分析你的 TLS 指纹或鼠标轨迹,单凭出口 IP 段的 ASN 属性(hosting 而非 isp),就能直接给请求打上高风险标签,轻则降权返回阉割版页面,重则直接丢进“AI 迷宫”消耗你的 Token 预算。关于如何核验出口的底层归属,可以参考我们此前整理的怎么查IP的ASN归属是不是ISP。
相比之下,动态住宅IP来自真实家庭宽带网络,归属于各地主流运营商(ISP)。将高并发的 Agent 请求分散到庞大的真实住宅节点池中,在目标站点看来,这些访问更接近分散在各地的普通家庭用户,从而在入口层大幅降低触发静默风控的概率。
二、单步检索 vs 多步交互:动态住宅IP的轮换与粘性怎么配?
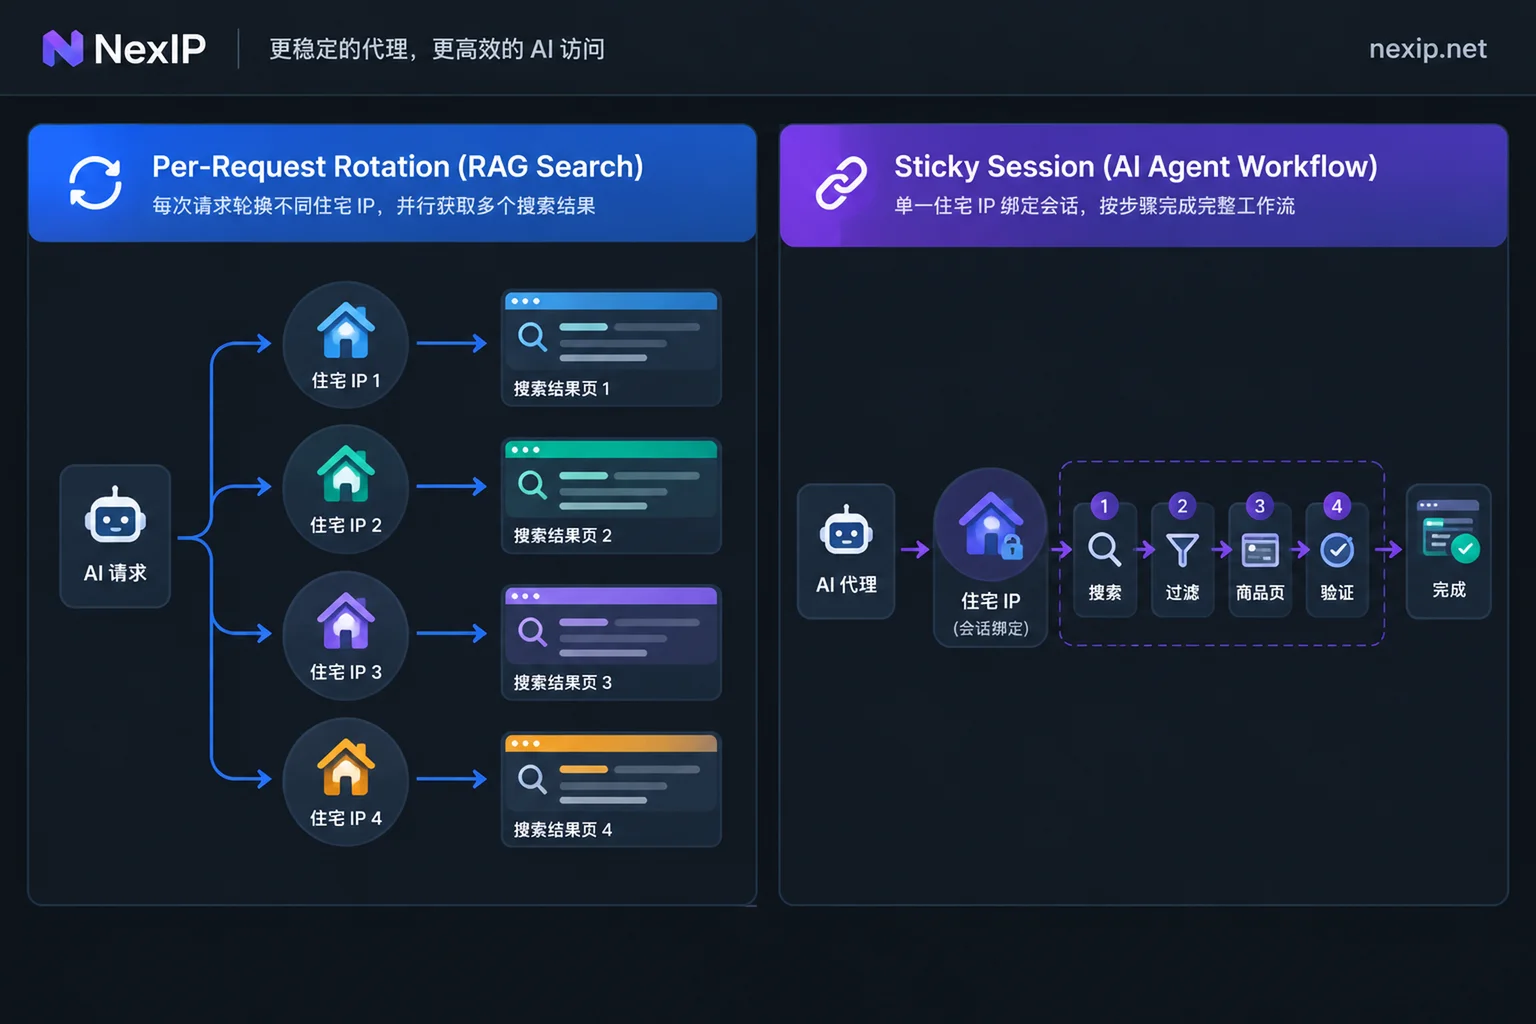
在 AI 应用方案中,不同阶段的网页访问对会话连续性的要求完全不同。拿到动态住宅代理后,不能所有任务都用同一套轮换逻辑,核心要分清“每请求轮换”和“粘性会话(Sticky Session)”的适用边界:
1. 公开语料抓取与 RAG 实时搜索:用“每请求轮换”
当任务是批量抓取公开百科、新闻正文、商品详情页,或者做 SERP 监控将搜索结果实时喂给大模型时,页面之间没有上下文状态依赖。
- 配置策略:开启每请求轮换。每次 HTTP 请求都从动态池中抽取一个新的住宅出口,最大化打散请求密度,避免因单 IP 请求频次过高撞上站点的速率限制(Rate Limit)。
2. AI Agent 多步网页操作:用“粘性会话”
如果 AI Agent 的任务是“打开某比价网站 → 输入邮编 → 筛选有货商品 → 点进详情页核对运费”,这是一个典型的有状态多步工作流。如果在点击下一页时出口 IP 突然从纽约跳到了达拉斯,站点服务端发现 Session 绑定的 IP 或地理位置突变,就会立刻清空筛选状态甚至弹验证拦截。
- 配置策略:开启粘性会话。让同一个 Agent 实例在执行完这一整套动作期间,临时保持同一个住宅 IP 出口,任务结束后再释放换新。(想深究底层机制的读者,可以延伸阅读会话粘性和静态IP是一回事吗以及动态IP多久换一次比较合适。)
3. 地区化内容对齐:按国家/城市/运营商定向
很多公开信息具有强地域属性——同一个搜索词或商品链接,在伦敦、东京和洛杉矶看到的库存、定价与推荐排序截然不同。在配置代理时,需要利用动态住宅代理的定向能力,按目标业务所在的国家、城市甚至本地运营商/ASN 锁定出口,确保 AI 检索回来的上下文与目标用户的真实物理视角一致。
三、AI 数据管道选型:按流量还是按带宽?动态还是静态?
在实际搭建或扩容 AI 数据基础设施时,工程团队通常要在计费模式和 IP 属性之间做组合优化。对照 NexIP 的产品矩阵,可以按以下逻辑对号入座:
| AI 业务场景 | 负载与会话特征 | 推荐产品类型 | 核心配置要点 |
|---|---|---|---|
| AI Agent 按需检索、训练语料扩充、RAG 问答查证 | 请求随用户提问或定时任务脉冲式触发,并发波动大,单次传输数据量可控 | 动态住宅代理·流量套餐 | 按流量(GB)计费;公开页面用每请求轮换,多步浏览用粘性会话 |
| 7×24 全天候舆情监测、实时库存追踪、高频接口轮询 | 持续运行、吞吐量稳定且全天在线,按流量算容易超支 | 动态住宅代理·带宽套餐 | 按端口带宽计费,不限流量(公平使用);支持自动轮换或粘性会话 |
| 临时账号验证、支付流程测试、接口联调 | 需要在几小时或几天内独占一个固定不变的 ISP 出口做闭环测试 | 静态住宅代理·短效 IP | 小时或天级租用,按 IP 计费,独占静态住宅出口,不限流量 |
| 长期维护海外 AI 平台账号登录态、固定身份运营 | 要求数月甚至整年固定同一个家庭宽带出口,严禁 IP 频繁跳变 | 静态住宅代理·长效 IP | 月或年级独占固定出口,可选家宽原生/广播及原生双 ISP,失效免费更换 |
如果你的团队正在纠结采集预算怎么算更划算,可以先看这篇按流量计费和按带宽计费怎么选,把并发峰值、单页体积和日均运行时长代入算一下账。
这里还要特别提醒一个常见的踩坑点:不要用动态住宅 IP 去登录需要长期维护的 AI 平台开发者后台或高价值订阅账号。动态池的设计初衷是打散公开数据采集的请求身份;而账号管理需要的是长期稳定的网络信誉,这类场景务必切回静态住宅长效 IP,做到专号专 IP(详见静态住宅IP和动态住宅IP哪个适合采集)。
四、工程接入与排查建议
当你在代码中把动态住宅代理接入 Playwright、LangGraph 或自研爬虫集群时,做好以下几项工程细节,能显著减少无效重试:
- 灵活选择接入与认证方式:NexIP 支持
HTTP/HTTPS/SOCKS5全协议。在容器化或无服务器(Serverless)环境中调度 Agent 时,可以使用账密认证配合账密带参(在用户名中传入国家、城市或粘性会话标识),或者在固定网关服务器上配置 IP 白名单认证,通过 API 提取或端口转发直接分发给下游工作节点。 - 剔除冗余静态资源:AI 训练和 RAG 检索通常只需要页面的核心 HTML 文本或 JSON 接口数据。即便用的是动态流量套餐,在无头浏览器层拦截图片、视频、字体文件和广告脚本的加载,不仅能把单页流量消耗压缩 70% 以上,还能大幅缩短 Agent 的页面等待时间。
- 建立响应层异常分流:遇到抓取质量下降时,不要无脑无限重试。先在响应层检查返回内容的文本熵和 DOM 结构特征,区分是目标站改版、撞上速率限制,还是触发了类似 AI Labyrinth 的假页面,再针对性地切换出口节点或调整会话时长(具体排查流程可参考采集成功率突然下降,先查出口还是先查目标站)。
- 用子账户做好团队与业务隔离:如果团队内部同时跑着 RAG 实时检索、竞品比价和 SEO 监控多条线,建议在用户后台通过面板或 API 创建独立的子账户,将不同项目的流量额度和出口凭证隔离开,方便按业务线核算单次有效请求的真实成本。
无论你是为大模型构建实时外部知识库,还是为多智能体工作流配置高可用的网页访问层,选对干净的住宅出口都是保障数据质量的第一道防线。你可以直接前往 NexIP AI 行业解决方案页 查看完整架构建议,或登录 NexIP 用户后台 获取测试凭证与接入文档,将真实的全球动态住宅网络快速集成到你的数据管道中。


评论(0)