 NexIP官方博客
采集成功率从九成掉到两三成,第一反应往往是换代理池,或者把重试次数拉满。这两步都会让排查变难:换池抹掉了现场,暴力重试则可能把一个本来只是被限速的任务,真的推进黑名单。
正确的第一步不是在"出口"和"目标站"之间二选一,而是先看报错落在哪一层。这一刀切下去,两类问题会自动分到两边,通常几分钟就能分完。
第一刀:请求到底有没有到达目标站
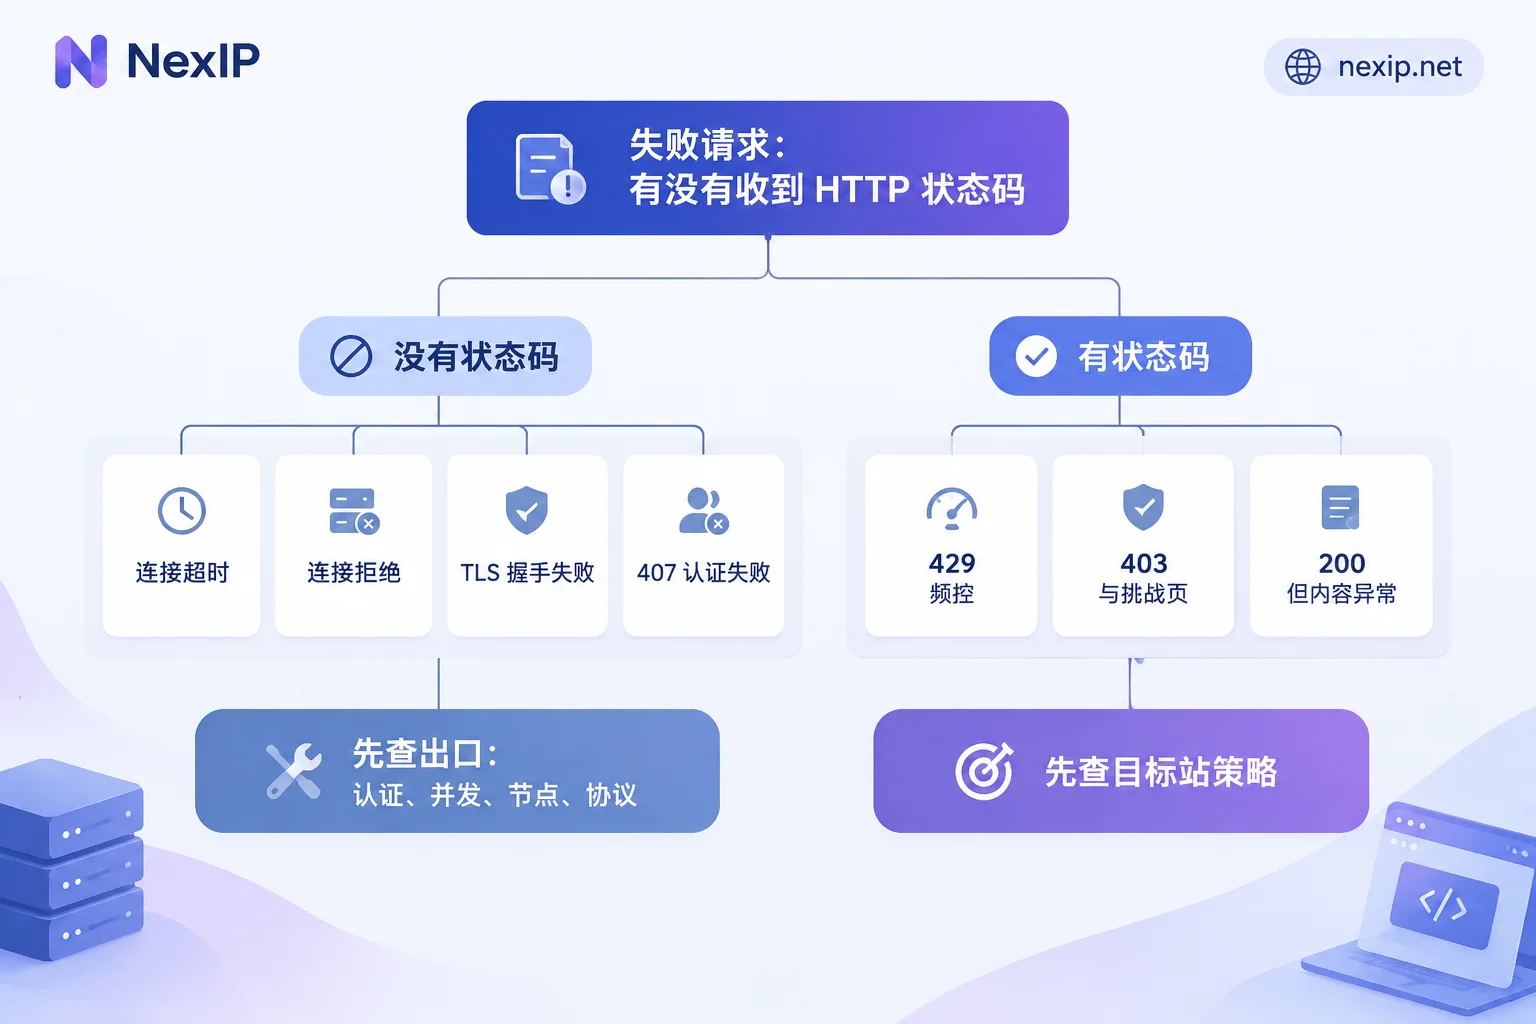
翻最近一批失败请求的日志,只回答一个问题:有没有拿到目标站返回的 HTTP 状态码。
没有状态码 —— 先查出口。 典型表现是连接超时(Connect Timeout)、连接被拒绝(Connection Refused)、TLS 握手失败,或者 407 Proxy Authentication Required。这类报错说明请求卡在你到代理、或代理到目标站的链路上,压根没走到对方服务器,目标站此刻的风控策略和你无关。
拿到了状态码(403、429、503 甚至 200 都算)—— 出口链路是通的。 物理通路没问题,被拦在应用层:对方看到了你的请求,然后决定怎么对待它。这时候换代理池大概率没用,还可能因为新 IP 触发更严的验证而更糟。
有一种情况会骗过这条规则:代理网关自己返回的错误页也带状态码。如果你收到的是 502/503,响应体很短又没有目标站的任何页面特征,先确认这是网关吐的还是目标站吐的——换一个出口把同一个 URL 重放一次,或在允许的情况下直连对比,就能分清。
走出口这条线:按顺序查四项
1. 认证。 407 几乎都落在这里。账密认证要检查用户名里拼接的地区、会话参数有没有写错;白名单认证更常见的故障是你自己的公网出口 IP 变了——重启路由、办公网换线、云主机换了弹性 IP,旧白名单就失效了。两种认证各自的适用场景和坑,可以看代理IP账密认证和白名单认证怎么选。
2. 并发与连接数。 掉成功率之前,你是不是刚把线程数调高了?多数套餐对同时在线连接数有约束,超了往往表现为超时或连接被拒,而不是明确报"超额"。把并发调回原值跑一小批,如果恢复,问题就定死在这里了。
3. 节点与网关可达性。 做最小复现:用 curl 走同一个代理去请求一个 IP 回显接口,看通不通、耗时多少。通了说明出口活着,不通就是节点或网关侧的事。
4. 协议与端口。 HTTP/HTTPS/SOCKS5 端口填错,或者客户端只给 http 配了代理、没给 https 配,都会表现成"一部分请求正常、一部分全挂",很容易被误读成目标站在挑着拦。
这四项都正常,就把注意力移回目标站。
走目标站这条线:按响应特征分流
429:先调节奏,别急着加 IP
429 Too Many Requests 的含义很明确——链路没问题,是速率踩线了。此时加代理、缩短重试间隔,只会把并发继续往上推,反而让对方把阈值收得更死。
先读响应头里的 Retry-After,有就按它等;没有就用指数退避(1 秒、2 秒、4 秒……并加随机抖动),同时把瞬时突发压下去——很多任务的问题不是总量大,而是同一秒里爆发一批请求。节奏稳住之后,如果吞吐确实不够,再考虑把请求摊到更大的轮换池里,让单个出口的频次落回阈值以下。
顺序不能反:先控速,再分散出口。 反过来做,你只是用更多 IP 去撞同一堵墙。
403、JS 挑战页、验证码:做一次基线重放
这类响应说明对方把你判成了异常来源,但"异常"可能指 IP,也可能指客户端特征。一次 A/B 重放就能把两者分开:
取一个失败的 URL,用本机真实浏览器、原生家宽网络,带上尽量一致的请求头,重放同一个请求。
- 原生环境能正常打开,代理出口打不开 → 问题偏向出口身份:IP 或 ASN 的信誉被目标站收紧了,机房段、广播类地址段被识别的概率更高。方向是换更贴近真实家宽的出口类型,而不是在代码里继续调参数。
- 原生环境同样被拒 → 和出口关系不大。可能是目标站整体升级了风控,可能是你的会话/Cookie 失效,也可能是请求头顺序、TLS(JA3)指纹这类客户端特征暴露。继续在客户端侧找。
重放时一次只改一个变量(只换出口,或只换客户端),否则结论没法用。
200 但内容不对:软拦截还是改版
只统计 HTTP 200 的比例,会漏掉最难受的一类失败:状态码正常,返回的却是空白页、安全验证占位页或登录重定向——也就是软拦截;另一种可能是目标站前端改版、接口字段换了名字,解析器拿不到数据。
要分清这两者,日志里至少记三样:status、content-length、响应体前几百字节。content-length 集体缩水到某个固定值,基本是软拦截;长度正常但结构变了,那是改版,属于你自己解析代码要跟进的活,和代理无关。
一个常被忽略的坑:假轮换
配了轮换代理,日志里 IP 参数每次都不一样,实际出口却一直是同一个——这种情况比想象中常见。原因在 HTTP 客户端的长连接与连接池:复用同一个 Session 对象时,底层默认对同一域名复用已建立的 TCP 连接,而代理是在建连那一刻确定的,后续请求就继续走老出口,直到这个 IP 被封。
验证方法只有一个靠谱:在真实任务的代码路径里,每隔若干个请求打一次 IP 回显接口,把返回的出口 IP 写进日志。连续多次相同,轮换就没生效。修法是按批次新建会话/连接池,或显式关闭长连接复用。各个 Python 客户端的具体写法可以看住宅代理怎么接进 Python 采集脚本。
反过来也成立:需要保持登录态的任务,如果连接池被频繁重建、每次请求都换出口,会话会莫名其妙掉线——那是另一个方向的配置问题,参考粘性会话怎么设置才不会中途掉登录态。
定位完了,再决定出口怎么调
走到这一步,结论通常落在三种之一,对应的动作也不同:
速率踩线(以 429 为主)。 先把节奏和并发改好;确实需要提高吞吐时,再用轮换型的动态住宅出口把频次摊开。这类任务 IP 复用率低、用量随任务波动,动态流量套餐按流量计费、支持轮换或粘性会话,比较贴;如果是长期常驻、流量不好估的任务,动态带宽套餐按带宽计费、不限流量,账更好算。
出口身份被识别(基线重放确认问题在 IP 侧)。 方向是换更接近真实家宽的出口,而不是继续往池子里加量。住宅 IP 的实际来源差异很大,到手先自己验一遍,别只看标称,伪住宅IP是怎么被包装出来的里列了可以自查的几项。
任务本身就要固定身份。 要登录、多步会话、对 IP 漂移敏感的场景(店铺后台、社媒账号、TK 运营),高频换 IP 反而是触发验证的原因。这类需要独占固定的静态住宅出口,按业务周期在静态短效 IP和静态长效 IP之间选;后者分家宽原生、家宽广播、数据中心三种,TK 运营官网建议用静态家宽原生。两者怎么按周期分档,可以参考静态短效和静态长效住宅IP该怎么选。
出口只解决"你从哪里出去"这一件事。如果基线重放指向的是浏览器指纹或账号本身,换再好的 IP 也补不回来,那部分归浏览器环境(NexBrowser)和账号侧(NexSHOPX、NexSMS)。
十分钟排查清单
按顺序走,别跳:
- 先停止扩大重试和换池,保留现场日志。
- 抽 50 条失败请求,分成"有状态码"和"无状态码"两堆。
- 无状态码那堆 → 依次查认证、并发、节点可达性、协议端口。
- 有状态码那堆 → 按 429 / 403 与挑战页 / 200 异常响应体 三类分流。
- 429:读
Retry-After,退避加降突发,之后再评估是否需要更大的轮换池。 - 403 与挑战页:在原生环境做基线重放,一次只改一个变量。
- 200:核对 content-length 与响应体前几百字节,分清软拦截和页面改版。
- 全程用 IP 回显确认轮换是否真的生效。
- 结论明确之后,再动出口类型和轮换策略——这一步放最后。
两个会改变结论的前提
这套顺序对大多数情况成立,但有两处要按你的实际情况调整。
对方用的是哪套防护。 Cloudflare、Akamai、DataDome 和各家自研的频控模块,对 TLS 指纹、IP 类型的敏感权重并不一样:有的对机房段近乎零容忍、却不太在意请求节奏,有的正相反。第一次碰到某个站点时,基线重放的实测结果比任何通用经验都可靠。
你的采集客户端是哪一种。 纯协议抓取(Requests、cURL、HTTPX)出 403,优先怀疑请求头顺序与 TLS 指纹;无头浏览器(Playwright、Puppeteer)出 403,更多是浏览器驱动特征和自动化痕迹。两者排查点不同,别互相套经验。


评论(0)